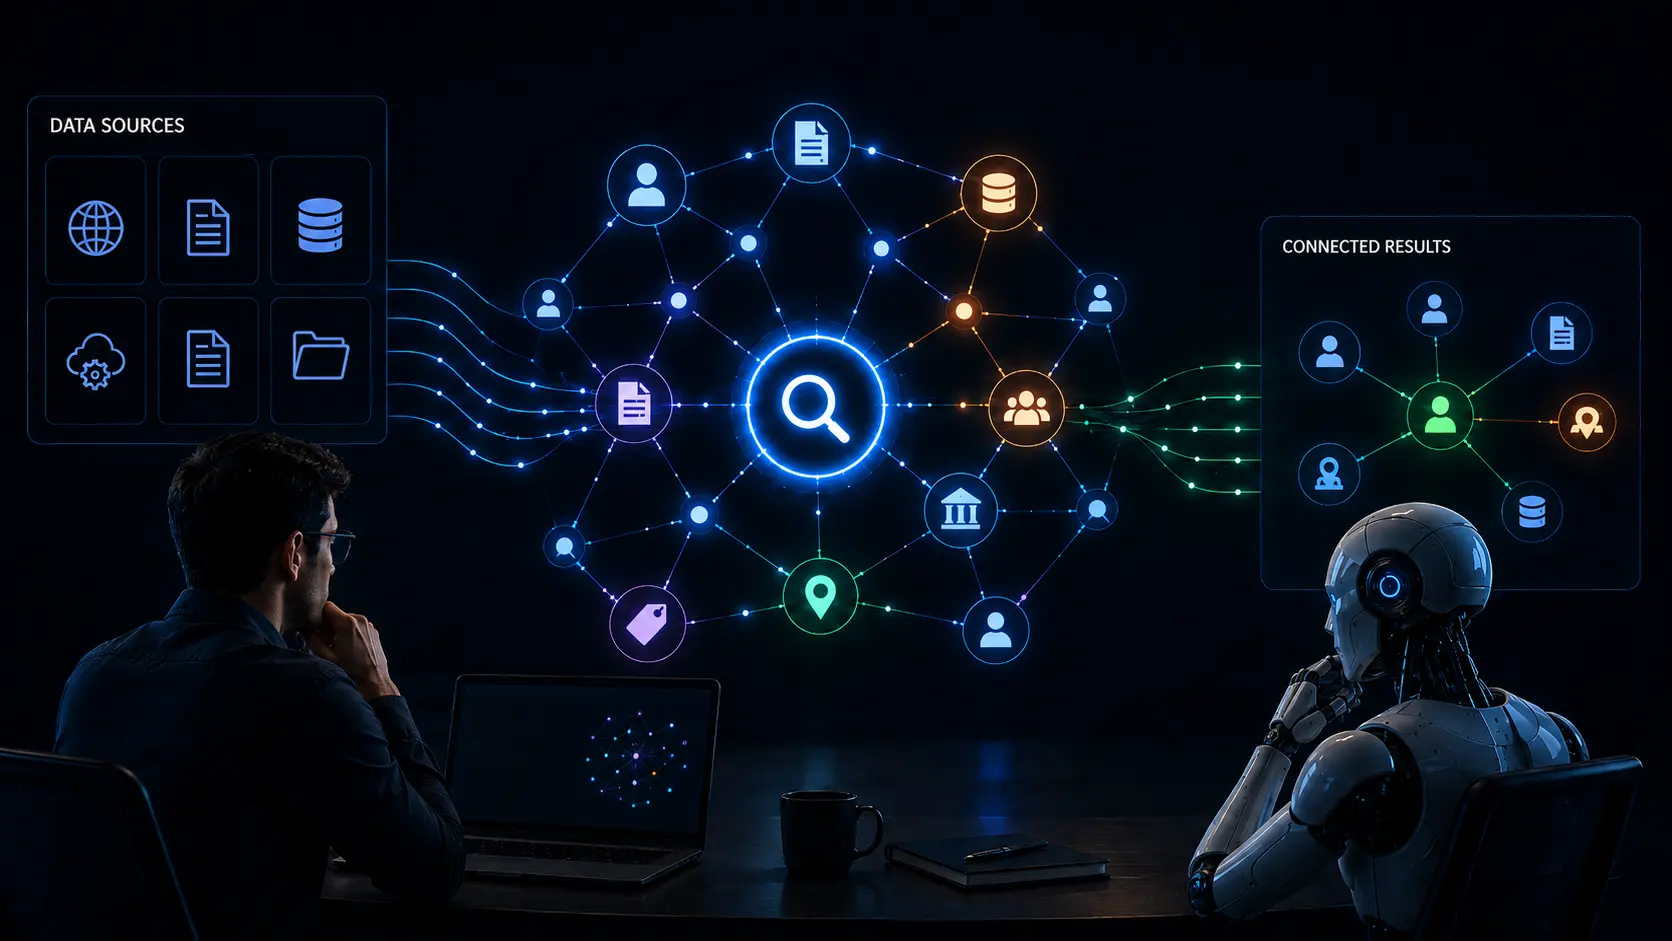
GraphRAG förklarat: Hur grafdatabaser hjälper AI-agenter att söka smartare
De flesta AI-sökverktyg idag fungerar på samma sätt: förvandla din fråga till en vektor, hitta de närmast matchande textstyckena och överlämna dem till en språkmodell. Detta fungerar bra tills din fråga beror på hur saker hänger ihop: "vem mer arbetar med det här ämnet", "vad har ändrats sedan förra året", "vilka forskningsrapporter citerar varandra". En vanlig sökning kan inte se samband. Den ser bara likheter.
Detta är exakt den lucka som grafdatabaser och GraphRAG är byggda för att stänga. Och det är inte en liten eller nischad idé: Google, LinkedIn, Netflix, Meta och nu Microsoft Fabric förlitar sig alla på grafteknik för att driva sökningar, rekommendationer och, i allt högre grad, AI-agenter. I den här artikeln kommer vi att förklara vad en grafdatabas är, vad GraphRAG betyder, hur AI-agenter använder ett språk som heter Cypher för att fråga grafer på vanlig engelska (eller svenska) och hur dessa idéer sammanförs i ett verkligt projekt.
I den här artikeln går vi igenom:
- Vad en grafdatabas faktiskt är, med ett enkelt exempel
- Vad GraphRAG innebär och hur det skiljer sig från vanlig RAG
- Cypher och Text2Cypher: hur AI-agenter ställer graffrågor med vanligt språk
- Verkliga system som redan använder grafteknik i stor skala
- Neo4j vs Memgraph: hur man väljer en grafdatabas
- Ett verkligt exempel på GraphRAG i praktiken
Vad är en grafdatabas?
En vanlig databas lagrar information i tabeller: rader och kolumner, som ett kalkylblad. Det fungerar bra tills du behöver ställa en fråga om hur saker förhåller sig till varandra. "Vilka författare har arbetat tillsammans?" eller "vilka forskningsrapporter delar ett ämne?" I en tabellbaserad databas innebär svaret att skriva flera JOIN-satser och hoppas att din databas kan hantera dem tillräckligt snabbt.
En grafdatabas lagrar data annorlunda. Istället för rader och kolumner lagrar den:
- Noder (Nodes): "sakerna" (en person, ett dokument, ett företag, en produkt)
- Kanter (Edges): relationerna mellan sakerna ("skrev", "arbetar på", "citerar")
- Egenskaper (Properties): extra detaljer kopplade till noder eller kanter (ett datum, ett namn, en poäng)
Relationer lagras direkt, de beräknas inte i farten. Så istället för att slå ihop fem tabeller för att hitta "författare som delar en genre med Ana Rivera", följer databasen bara de befintliga kopplingarna.
💡 Varför detta spelar roll Relationerna lagras som förstklassig data, de räknas inte om varje gång. Det är det som gör multi-hop-frågor (frågor som kräver två eller tre "hopp" över relationer) snabba, även på stora datamängder.
Vad är GraphRAG?
GraphRAG står för Graph Retrieval-Augmented Generation. Det bygger på samma grundidé som normal RAG (ge språkmodellen riktig data istället för att låta den gissa), men den hämtar den datan från en graf istället för en platt lista med textstycken.
Normal RAG bryter ner dokument i stycken (chunks), förvandlar varje stycke till en vektor och hittar de stycken som till sin innebörd är mest lika din fråga. Detta är utmärkt för frågor som rör enskilda fakta. Metoden får problem i det ögonblick din fråga beror på en relation som sträcker sig över mer än ett textstycke.
Exempel: "Vilka andra författare har skrivit en mysterieroman, och har någon av dem arbetat tillsammans?" En ren vektorsökning kommer att hitta textstycken som nämner "mysterium", men den har inget tillförlitligt sätt att räkna ut vem som samarbetat med vem. En graf lagrar redan den kopplingen direkt, som en kant mellan två författarnoder.
GraphRAG glänser när svaret beror på struktur, inte bara ordval: forsknings- och citeringsanalys, bedrägeribekämpning, leveranskedjor, juridiska dokument och företagsövergripande kunskapsbaser som spänner över många länkade dokument.
Hur GraphRAG svarar på en fråga
Flödet, steg för steg:
- Du ställer en fråga på vanligt språk.
- En AI-agent omvandlar din fråga till en graffråga (mer om detta nedan).
- Grafdatabasen traverserar (följer) de faktiska relationerna som existerar mellan noderna.
- Sammanhängande fakta returneras: inte bara ett matchande objekt, utan hela nätet av relaterade författare, böcker och genrer.
- Språkmodellen formulerar sitt svar med hjälp av dessa verkliga, sammanhängande fakta, istället för att gissa.
🚀 Den avgörande skillnaden Normal RAG frågar: "Vilken text liknar den här frågan?" GraphRAG frågar: "Vad är faktiskt kopplat till det jag letar efter?" Den andra frågan är det som gör resonemang i flera steg (multi-hop) möjligt.
Cypher och Text2Cypher: Att lära AI-agenter att ställa graffrågor
Grafdatabaser har sitt eget frågespråk, och det mest använda kallas Cypher. Det läses lite som att rita det mönster du letar efter. Den här raden hittar alla mysterieböcker som publicerats efter 2020:
MATCH (b:Book)-[:GENRE]->(g:Genre {name: "Mystery"}) WHERE b.year > 2020 RETURN b.title
Cypher är kraftfullt, men de flesta (och de flesta affärsanvändare) kan det inte, och borde inte behöva kunna det. Det är här AI-agenter kommer in. Ett välkänt mönster kallat Text2Cypher (eller NL2Cypher) använder en språkmodell för att översätta en fråga på vanligt språk direkt till en fungerande Cypher-fråga, köra den och returnera resultaten.
Detta är en välkänd byggsten för AI-agenter: istället för att agenten gissar ett svar, skriver den en riktig databasfråga, kör den och grundar sitt svar i det som faktiskt returneras. Det är samma idé som att ge en kollega databasåtkomst istället för att be dem svara ur minnet.
- Stora grafer innebär stora scheman: att mata en AI-agent med hela schemat kan överbelasta dess kontext, så produktionssystem hämtar vanligtvis bara den relevanta delen av schemat först.
- Genererade frågor är inte alltid perfekta första gången: bra system lägger till omladdningslogik (retry logic) som fångar ett fel och försöker igen ett par gånger innan de ger upp.
- Ju mer specifika dina relationer och egenskapsnamn är, desto mer tillförlitligt kan en AI-agent generera en korrekt fråga.
⚡ Varför det är spännande för AI-agenter Text2Cypher förvandlar en grafdatabas till ett verktyg en AI-agent kan använda på egen hand, på samma sätt som den kan anropa ett väder-API eller en kalender. Ställ en fråga på engelska eller svenska, och få tillbaka ett svar grundat i riktig, sammanhängande data.
Verkliga system som redan använder grafteknik
Detta är inte en framtidsvision: det körs redan bakom några av de produkter du använder varje dag. Här är en snabb titt på vilka som förlitar sig på grafteknik, och varför.
Netflix: en 650 TB-graf, byggd för hastighet Netflix kör ett internt system som kallas Graph Abstraction, som hanterar nära 650 terabyte grafdata med ungefär 10 miljoner operationer per sekund. Det driver tre mycket olika jobb samtidigt: en realtidskarta över relationer över hela plattformen, en social graf inuti Netflix Gaming och en live-karta över interna tjänster som används för att undersöka avbrott. Separat använder Netflix ett graf-neuralt nätverk kallat SemanticGNN, som blandar "personer som tittade på detta tillsammans"-signaler med "detta har en liknande genre och stämning"-signaler i en enda graf, vilket hjälper till att rekommendera nyare titlar som inte har mycket visningshistorik ännu.
LinkedIn och Meta: grafer byggda för deras egen skala LinkedIn byggde sin egen grafmotor, internt kallad Liquid, för att betjäna sin Economic Graph i realtid: det är det som driver "Personer du kanske känner" och jobbrekommendationer. Meta (Facebook) byggde TAO, en graflösning som renderar ditt nyhetsflöde genom att följa den sociala grafen med strikta sekretesskontroller, i en skala av miljarder läsningar per dag. Båda företagen valde att bygga anpassade system istället för att använda en färdig grafdatabas, eftersom i deras skala räknas varje millisekund och varje byte.
Microsoft Fabric: tar LinkedIns grafteknik till alla företag Under 2025 och 2026 började Microsoft rulla ut ett graflager inuti Microsoft Fabric, byggt direkt på idéerna om relationsmodellering som bevisats på LinkedIn. Målet är att ge AI-agenter inom företag en verklig, sökbar modell av hur ett företags data hänger ihop (kunder till köp, leverantörer till produkter) istället för att tvinga en agent att gissa på relationer gömda i separata tabeller.
🏆 Mönstret att lägga märke till Inget av detta är nytt: Google, LinkedIn och Facebook har använt graftänkande i över ett decennium. Det som är nytt är att exakt samma mönster nu riktas mot LLM:er och AI-agenter, och paketeras så att alla företag kan använda det, inte bara tech-jättarna (hyperscalers).
Att välja en grafdatabas: Neo4j vs Memgraph
Om du bygger ditt eget system istället för en intern hyperscale-plattform, kommer du troligen att välja mellan ett litet antal produktionsklara grafdatabaser. De två vanligaste är Neo4j (originalet och den mest etablerade) och Memgraph, ett nyare, snabbare alternativ byggt för arbetsbelastningar i realtid.
Ingetdera är "bättre": de är byggda för olika kompromisser. Om din datamängd är enorm och mestadels historisk är Neo4js mognad och verktyg svåra att slå. Om du behöver svar med låg latens för en live AI-agent som arbetar över en graf som bekvämt ryms i minnet, är Memgraph byggd exakt för det fallet.
Ett verkligt exempel: Att bygga en graf för forskningskunskap
Dessa exakta idéer samverkar i en instrumentpanel för arktiska forskningstrender: ett system utformat för att hjälpa forskare att utforska vetenskaplig litteratur på det sätt den faktiskt beter sig, som ett nät av författare, rapporter, institutioner och ämnen, inte en platt lista med sökresultat.
- Varje forskningsrapport, författare, institution och ämne blev en nod, och varje "skrev", "citerar" och "arbetar på"-relation blev en kant, med Memgraph som grafmotor.
- Ett NL2Cypher-fråge-och-svar-lager låter en forskare ställa en fråga på vanligt språk och få tillbaka ett svar grundat i den faktiska grafen, inte en gissning.
- Ett vektor-semantiskt söklager sitter vid sidan av grafen, för de fall där meningsbaserad sökning verkligen är rätt verktyg.
- En "Expert Finder"-funktion använder graftraversering för att svara på en mycket grafformad fråga, "vilka är rätt personer att prata med om detta ämne?", genom att följa medförfattarskap och ämnesrelationer, inte bara nyckelordsmatchningar.
Detta speglar det exakta GraphRAG-mönstret som beskrivs ovan: en fråga på vanligt språk, översatt till en graffråga av en AI-agent, besvarad med verkliga, sammanhängande fakta. Det är ett bra exempel på hur ett mönster som startade hos tech-jättarna nu är praktiskt tillämpbart för ett mycket mindre, fokuserat projekt.
GraphRAG vs Normal RAG: Sida vid sida
Sammanfattning
Grafdatabaser och GraphRAG är inte en ersättning för allt du redan vet om RAG: de är ett extra verktyg för det specifika ögonblicket när din datas verkliga värde ligger i dess relationer, inte bara i dess ord. Mönstret är bevisat: Google, LinkedIn, Netflix och Meta har byggt hela produkter på det, och Microsoft paketerar nu samma idé för varje företag, rakt riktat mot AI-agenter.
- En grafdatabas lagrar relationer direkt, så multi-hop-frågor förblir snabba även i stor skala.
- GraphRAG hämtar ett sammanhängande nät av fakta istället för isolerade textstycken.
- Cypher och Text2Cypher låter AI-agenter ställa frågor till en graf på vanligt språk och grunda sina svar i verklig data.
- Valet mellan Neo4j och Memgraph (eller en annan grafdatabas) beror på din datastorlek och hur mycket realtid din arbetsbelastning kräver.
När du väljer rätt verktyg för formen på din data, inte bara det populära, slutar du kämpa mot din databas och börjar bygga något som faktiskt förstår hur din information hänger ihop. Det är det verkliga målet.